


Efectivamente no se trata de una bola retroiluminada en blanco, de cristal traslúcido.
No se pretende realizar un examen exhaustivo de todos los posibles mecanismos que se utilizan bajo el paraguas del Aprendizaje Automático y la Inteligencia Artificial, en la detección de situaciones anómalas como son los casos de fraude.
Quizá mediante un ejemplo más o menos real y más o menos sencillo, podemos aproximarnos al funcionamiento de una predicción, que puede ser usada más tarde para determinar y separar un hecho fraudulento del que no lo es.
Una predicción, salvo aquellas que se hacen con la bola de cristal, se basa en datos, del conocimiento previo de la normalidad o anormalidad de transacciones históricas. Con ello nos ceñimos al entorno de los procedimientos, técnicas o algoritmos que se denominan supervisados, es decir que toman en consideración una clasificación previa de hecho normales y anormales en la muestra histórica que sirve como aprendizaje para nuestro modelo predictivo.
Pongamos que, dentro de la transacción, tenemos un elemento, que toma diferentes valores representando alguna característica intrínseca de la transacción como su procedencia o en qué sector de actividad se realiza o cualquier otra propiedad.
Tomamos todas las transacciones, las clasificamos según se hayan considerado normales o anormales y acumulamos el número, distribuyéndolas de acuerdo con el valor que tomaba el elemento en cuestión en cada una de ellas. Normalizamos las cantidades de transacciones normales y anormales para cada uno de estos valores y obtenemos una gráfica como la que aparece a continuación.
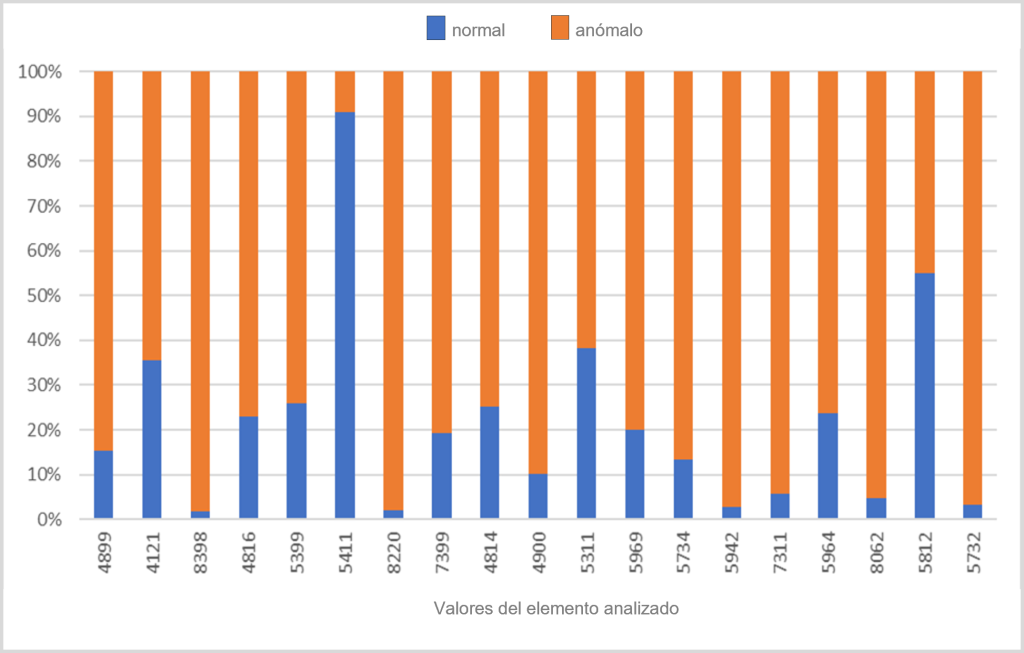
Sin ahondar en los cálculos que permiten obtener una probabilidad o un ‘score’ de anormalidad para una transacción, es evidente que encontramos en la gráfica valores para ese elemento, que si los toma en la transacción objeto de análisis diríamos que aumenta la probabilidad que tenga alguna anormalidad. Señalamos por ejemplo los valores 8220, 8398, 5942, 7311 y alguno más. Por el contrario, las que poseen valores como 5411, 5812 o 5311, digamos que serían probablemente transacciones normales. Es obviamente una simplificación, no por ello incorrecta, pero sirve además para ilustrar algunas ideas,
- Los datos encierran información (esto no es nada nuevo).
- Es importante el tratamiento y ordenación de la información (bastante conocido)
- Hay elementos con capacidad de discriminación entre normales y anormales.
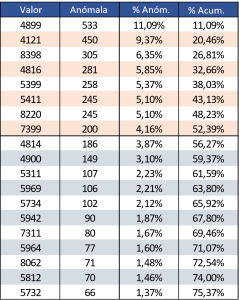
Los valores posibles para el elemento seleccionado en nuestras transacciones son más que estos 19 que aparecen en la gráfica; de hecho, son más de 1000 posibles y más de 300 habitualmente encontrados en las transacciones. Sin embargo, otra conclusión obtenida de este análisis inicial fue que estos 19 valores aparecían en el 75% de las transacciones clasificadas como anormales.
También esto explica por qué la gráfica anterior mostraba una abundancia del tramo normalizado de transacciones anómalas y que prácticamente 4 o 6 valores son los únicos que permitirían posicionar una transacción en la normalidad.
Lo que hemos llamado capacidad de discriminación también se le conoce como poder predictivo de un elemento, es decir, en lo que se basan las predicciones es en el hecho de que algunos valores de algunos elementos de las transacciones aumentan la probabilidad de que la misma sea calificada como normal o como anómala.
Cuando este análisis lo completamos con la prevalencia de los distintos valores del elemento, y tenemos en cuenta más de un único elemento, la capacidad de predicción aumenta y, sobre todo, el acierto, huyendo de los falsos positivos, también crece.
El proceso es algo más elaborado, iterativo y toma en consideración algunos aspectos que tienden a limpiar y preparar la información adecuadamente, pero lo significativo es que no hay bola de cristal, son datos, y el análisis de un volumen adecuado de los mismos nos permite, entre otras cosas, calcular la probabilidad de que una nueva transacción sea normal o anormal, de acuerdo con el aprendizaje realizado.


